Un SLM pourrait-il devenir radioamateur ?
TLDR : vraisemblablement oui, même sur une machine avec uniquement 8 Go de vRAM… en tout cas autant qu’un humain ! Les écueils de la création d’un benchmark sont aussi évoqués ici, comme l’importance d’avoir un prompt incitatif neutre (neutral nudge prompt). Mais attention, la sensibilité aux prompts pour un petit modèle est grande. Cela ne veut pas dire que l’on ne peut pas trouver un prompt pour chaque modèle qui le fasse mieux réussir.
Examen Radioamateur
Je suis radioamateur. Pour cela, il faut passer un examen organisé par l’ANFR. Il consiste en un QCM comportant 20 questions de réglementation et 20 questions de type technique. Une seule réponse est exacte. La calculatrice est autorisée mais pas les notes ou livres. Il faut donc connaître les limites des bandes de radiofréquences, mais aussi le code couleur des résistances, etc.
NB : Je ne peux que vous recommander de passer cet examen pour qui veut expérimenter et comprendre les radiofréquences, communiquer à travers le monde, ou entre machines. C’est un vrai terrain de jeu avec plein de hobbys dans le hobby.
SLM
D’un autre côté, en tant que passionné d’informatique, je ne peux que suivre les évolutions de l’IA générative (GenAI / LLM) et plus particulièrement son déploiement en local. Quand on dit en local, cela veut dire que le modèle est utilisé sur ma machine sans dépendance à Internet et aux grands fournisseurs d’IA bien connus. Ceux-ci “exécutent” (on parle d’inférences) des grands modèles, d’où le “L” de LLM pour “Large Language Model”. N’ayant pas un datacenter sous la main mais uniquement une carte graphique Nvidia RTX 2080 avec 8 Go de vRAM, je ne pourrai utiliser que des petits modèles : Small Language Model (SLM). Ces modèles existent en différentes versions basées sur la taille des paramètres. C’est ce que l’on appelle la quantification.
Ceci sera donc le fil conducteur de mes tests à venir. Certains pourraient dire que je compare des choses différentes à cause des quantifications différentes mais mon objectif est d’obtenir le meilleur score pour MA machine. Les experts noteront d’ailleurs que 8 Go de vRAM, c’est vraiment peu malgré les progrès des SLMs.
Questions d’examen
Revenons-en à la question de cet article : un SLM peut-il devenir radioamateur ? Pour cela, il nous faudrait les questions de l’examen, mais elles ne sont pas publiques. Par contre, un groupe de radioamateurs rassemble depuis des années les souvenirs des questions que les nouveaux radioamateurs ont eues lors de leurs passages. Elle sert notamment dans la merveilleuse suite d’outils pour réviser appelée Exam’1. Personnellement, j’avais utilisé la version Android. Bref, nous avons donc sous la main une base de données d’environ 2900 questions parfaitement exploitables ! Mais de nombreuses questions se basent sur des schémas, soit de circuits électroniques, soit de synoptiques de transceivers. Une sélection doit être faite sur des modèles multimodaux, c’est-à-dire capables d’interpréter les images nativement.
Llama-server et modèles multimodaux
Passons dans le concret maintenant. J’utilise llama-server pour exposer localement une API d’inférence. C’est lui qui déploie et exécute le modèle. Mais comme vous allez le voir après, utiliser un agent, ce n’est pas que juste envoyer du texte et recevoir du texte en réponse. Il y a certains formats à respecter pour que le SLM puisse appeler des outils (fonctions) comme Python, par exemple. Cela fait partie des nombreuses options de llama-server auxquelles il faut faire attention, comme le fait aussi de ne gérer qu’une session à la fois (--parallel 1). Voici au final, les modèles, leurs quantifications, et les templates que j’ai utilisés :
| Modèle | Quantification | Fichier Poids GGUF | Template de Chat (Jinja) | Format d’Appel d’Outils |
|---|---|---|---|---|
| Gemma-4-E4B-it | Q4_K_M |
gemma-4-e4b-it-q4_k_m.gguf |
NousResearch-Hermes-2-Pro-Llama-3-8B-tool_use.jinja |
ChatML / Hermes Tool-Use |
| Ornith-1.5-9B | Q3_K_M |
ornith-1.5-9b-q3_k_m.gguf |
NousResearch-Hermes-2-Pro-Llama-3-8B-tool_use.jinja |
ChatML / Hermes Tool-Use |
| Ministral-3-8B-Instruct | Q4_K_M |
ministral-3-8b-instruct-q4_k_m.gguf |
mistral_official_chat_template.jinja |
Officiel Mistral [TOOL_CALLS] |
| Qwen3-VL-8B-Instruct | Q3_K_M |
Qwen_Qwen3-VL-8B-Instruct-Q3_K_M.gguf |
froggeric_qwen_chat_template.jinja |
ChatML (Ajusté sans pré-injection <think>) |
| Qwen2.5-VL-7B-Instruct | Q4_K_M |
qwen2.5-vl-7b-instruct-q4_k_m.gguf |
froggeric_qwen_chat_template.jinja |
ChatML / Qwen Native |
| Phi-4-Multimodal-Instruct | Q4_K_M |
phi4-mm-Q4_K_M.gguf |
phi4_official_chat_template.jinja |
Phi-4 Native (<|end|>) |
| Pixtral-12B | Q3_K_M |
mistral-community_pixtral-12b-Q3_K_M.gguf |
mistral_official_chat_template.jinja |
Officiel Mistral [TOOL_CALLS] |
| Qwen3.6-35B-A3B (MoE) | UD-IQ2_M |
Qwen3.6-35B-A3B-UD-IQ2_M.gguf |
froggeric_qwen_chat_template.jinja |
ChatML / Qwen Native |
Préparation du benchmark & Inspect AI
Cette liste est définie a posteriori car j’ai utilisé tout d’abord un script développé à façon sur la base de 20 questions pour voir ce que cela donnait. Et cela m’a permis d’affiner certains critères déjà mentionnés, comme l’aspect multimodal ou encore le fait d’être full GPU (option -ng de llama-server).
Par exemple, à un moment, j’avais ces (faux et insignifiants) résultats mais véritables indices sur la direction à prendre :
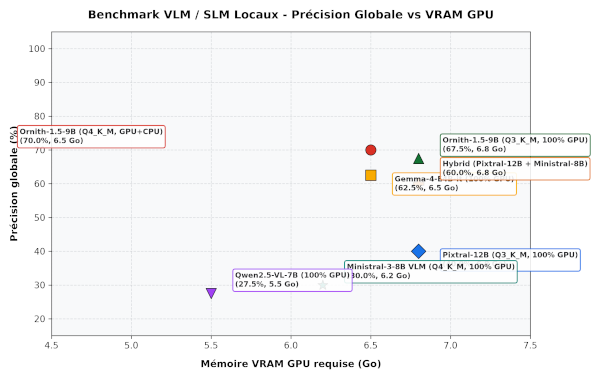
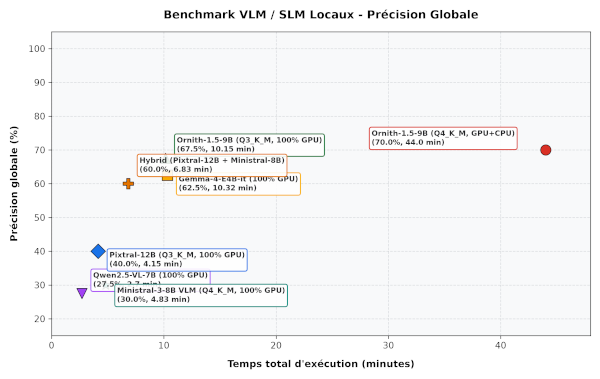
On voit par exemple qu’Ornith en Q4 était bien plus lent car je l’avais mal configuré et qu’il tournait partiellement sur mon CPU. On voit aussi que j’ai testé un pipeline de traduction d’une image en texte, puis l’utilisation d’un autre SLM pour répondre à la question (sans trop de succès). Bref, j’ai aussi beaucoup fait crasher llama-server avant d’arriver à un benchmark stable.
D’ailleurs quand llama-server crashe, je compte faux à la question et je le relance avant de passer à la question suivante.
Dans le lot, j’ai aussi vu des raisonnements corrects mais des résultats numériques faux. Il est bien connu que les LLMs sont mauvais de ce point de vue.
Dans la base de questions, j’ai trouvé aussi que les images étaient systématiquement liées aux questions alors même que certaines étaient déjà exactement traduites dans la partie textuelle. De même, certains résultats de reconnaissance de caractères étaient imparfaits (par exemple Ension au lieu de Tension). J’ai donc fait un petit nettoyage pour corriger les fautes d’OCR et liée l’image uniquement lorsqu’elle est complémentaire au texte.
Une fois ces préliminaires faits, je suis passé à Inspect AI. C’est un framework de tests dédié à l’IA. Il permet facilement d’exprimer un benchmark, son harnais, et de traquer les résultats des exécutions. C’est essentiel pour passer d’un script dans un coin de table à un benchmark reproductible. Il permet de définir le prompt système, le prompt utilisateur, les timeouts, les outils auxquels le LLM a accès, etc. Or, après un rapide test sur un sous-ensemble de questions, on voit qu’il y a une grande diversité dans les capacités des SLMs.
Prompt système et utilisateur
J’en suis donc venu à définir 4 configurations différentes :
- one-shot : le SLM n’a accès à rien d’autre que lui-même. Cela permet de tester la connaissance en propre du modèle.
- python uniquement : le SLM peut exécuter du code Python et donc s’en servir comme calculatrice.
- python + aide-mémoire : le SLM a toujours accès à Python mais peut aussi appeler 2 outils, un qui lui donne les limites de bandes applicables en France, et un autre outil qui lui donne un rappel des principales formules (loi d’Ohm, etc.).
- tous les outils précédents plus aide-mémoire directement dans le prompt système : comme précédemment, mais en plus on indique explicitement les limites dans le prompt.
A posteriori, on pourrait se demander pourquoi cette configuration n°4. Mais en fait, les petits SLMs se font vite distraire et ne vont pas forcément faire appel à l’outil leur donnant les limites de bandes, alors que s’ils l’ont dans leur contexte, ils seraient plus à même de répondre correctement. Oui, c’est forcément un peu tricher mais il ne faut pas oublier que le contexte, c’est un peu comme la mémoire à court terme. Certains d’entre nous relisent leurs fiches de révision juste avant de rentrer dans le centre d’examen. Et puis intellectuellement, c’est intéressant de comprendre les limites des SLMs…
Le prompt utilisateur est assez simple :
Question : [Texte de la question]
Propositions :
A. [Option A]
B. [Option B]
C. [Option C]
D. [Option D]
INSTRUCTION IMPÉRATIVE :
Examine attentivement le schéma ou l’image fournie (si présente), utilise tes connaissances et tes outils pour vérifier la bonne réponse. Indique ta réponse finale sur la DERNIÈRE LIGNE de ta réponse au format exact :
Réponse : X (où X est la lettre A, B, C ou D).
[Image si présente]
Le prompt système est lui configurable sur 4 niveaux pour aller de minimaliste, puis introduit la calculatrice via Python, puis des feuilles de triche, voire carrément contenir les informations de base. En fonction des résultats, cela devrait me permettre de comprendre quels modèles utiliser plus tard et comment bien les utiliser. À ce stade, je m’attends à une amélioration entre la configuration 1 et 2 sur la partie technique, une amélioration entre la 1 et la 3 sur la partie réglementation, une amélioration entre la 1 et la 4 à condition que le prompt ne consomme pas trop de contexte…
Après quelques tests, il s’avère que le prompt peut subtilement perturber le taux d’appels inutiles aux fonctions. Par exemple, le modèle appelle Python sur des questions réglementaires. À l’inverse, avoir les outils à disposition lui met parfois le doute et le pousse de nouveau à faire des appels. Il a donc fallu essayer de suivre les bonnes pratiques de prompt incitatif neutre (ou neutral nudge prompt). C’est loin d’être simple !
📌 Configuration 1
Zero-Shot Baseline : prompt_mode=’agent_only’, tools_mode=’none’
Cette configuration teste la connaissance intrinsèque du modèle.
Tu es un expert diplômé radioamateur français (F4). Tu réponds aux questions de l’examen avec rigueur et précision.
📌 Configuration 2
Python Seul : prompt_mode=’agent_only’, tools_mode=’python-only’
Cette configuration met la calculatrice à disposition mais teste encore la connaissance intrinsèque du modèle.
Tu es un expert diplômé radioamateur français (F4). Tu réponds aux questions de l’examen avec rigueur et précision.
Tu as accès à l’outil
pythonpour exécuter des calculs numériques exacts. Directives :
- Pour les questions de Réglementation : réponds directement de mémoire.
- Pour les questions de Calculs ou Radioélectricité : réponds directement ou utilise l’outil
pythonpour calculer ou vérifier la valeur exacte.
📌 Configuration 3
Fiches à la demande : prompt_mode=’agent_only’, tools_mode=’full’
Cette configuration apporte la calculatrice et les aides-mémoire. Elle permet de voir si avec les connaissances, le modèle peut se sortir des pièges des spécificités françaises.
Tu es un expert diplômé radioamateur français (F4). Tu réponds aux questions de l’examen avec rigueur et précision.
Tu as accès aux outils
lookup_bandplan(limites de bandes),get_essential_formulas(formules RF) etpython(calculs numériques). Directives :
- Pour les questions de Réglementation ou de définitions : réponds directement de mémoire (ou consulte
lookup_bandplanen cas de doute sur une borne).- Pour les questions de Calculs ou Radioélectricité : réponds directement ou utilise l’outil
pythonpour vérifier la valeur exacte.
📌 Configuration 4
Prompt In-Context Complet + Outils : prompt_mode=’full’, tools_mode=’full’
Cette configuration est un coup de pouce apporté aux tout petits modèles qui ne font pas appel aux outils malgré leur mise à disposition. Elle agit comme quelqu’un qui relirait ses fiches juste avant d’entrer dans le centre d’examen.
Au passage, elle vous donne le contenu renvoyé par les outils susnommés.
Tu es un expert diplômé radioamateur français (F4). Tu réponds aux questions de l’examen avec rigueur et précision.
Tableau officiel des bandes et limites de fréquences radioamateurs (France métropolitaine - ARCEP) :
- Bande 160m : 1,810 MHz à 1,850 MHz (Limites : 1,810 MHz et 1,850 MHz)
- Bande 80m : 3,500 MHz à 3,800 MHz (Limites : 3,500 MHz et 3,800 MHz)
- Bande 40m : 7,000 MHz à 7,200 MHz (Limites : 7,000 MHz et 7,200 MHz)
- Bande 30m : 10,100 MHz à 10,150 MHz (Limites : 10,100 MHz et 10,150 MHz)
- Bande 20m : 14,000 MHz à 14,350 MHz (Limites : 14,000 MHz et 14,350 MHz)
- Bande 17m : 18,068 MHz à 18,168 MHz (Limites : 18,068 MHz et 18,168 MHz)
- Bande 15m : 21,000 MHz à 21,450 MHz (Limites : 21,000 MHz et 21,450 MHz)
- Bande 12m : 24,890 MHz à 24,990 MHz (Limites : 24,890 MHz et 24,990 MHz)
- Bande 10m : 28,000 MHz à 29,700 MHz (Limites : 28,000 MHz et 29,700 MHz)
- Bande 6m : 50,000 MHz à 52,000 MHz (Limites : 50,000 MHz et 52,000 MHz)
- Bande 2m : 144,000 MHz à 146,000 MHz (Limites : 144,000 MHz et 146,000 MHz)
- Bande 70cm : 430,000 MHz à 440,000 MHz (Limites : 430,000 MHz et 440,000 MHz)
- Bande 23cm : 1240,000 MHz à 1300,000 MHz (Limites : 1240,000 MHz et 1300,000 MHz)
Fréquences limites notables :
- 14,350 MHz (borne supérieure de la bande 20m)
- 24,990 MHz (borne supérieure de la bande 12m)
- 50,000 MHz (borne inférieure de la bande 6m)
- 144,000 MHz (borne inférieure de la bande 2m)
- 430,000 MHz (borne inférieure de la bande 70cm)
- 1240,000 MHz et 1300,000 MHz (bornes de la bande 23cm)
Formules essentielles F4 (Électricité & RF) :
- Loi d’Ohm : U = R × I
- Puissance : P = U × I = I² × R = U² / R
Énergie / Charge : Q = I × t W = P × t - Transformateur parfait : Np / Ns = Up / Us = Is / Ip (Rapport de transformation : m = Ns / Np)
Impédance caractéristique ligne : Coaxial Z₀ ≈ 138 × log₁₀(D / d) Ω Ligne bifilaire Z₀ ≈ 276 × log₁₀(2D / d) Ω
Fréquence & Longueur d’onde : λ (m) ≈ 300 / f (MHz) f (MHz) ≈ 300 / λ (m) - Antenne dipôle λ/2 : Longueur totale (m) ≈ 142 / f (MHz)
- Fréquence de résonance : f₀ = 1 / (2π √(L × C))
Réactances : XL = 2π f L XC = 1 / (2π f C)
Décibels : Gain Puissance = 10 × log₁₀(P₂ / P₁) Gain Tension = 20 × log₁₀(U₂ / U₁)
Rappels dB : +3 dB = Puissance × 2 +6 dB = Tension × 2 Tu as accès à l’outil
pythonpour exécuter des calculs numériques exacts. Directives :
- Pour les questions de Réglementation : réponds directement de mémoire.
- Pour les questions de Calculs ou Radioélectricité : réponds directement ou utilise l’outil
pythonpour calculer ou vérifier la valeur exacte.
Description d’outils
Initialement, j’avais ajouté l’outil Python natif d’Inspect AI. Mais il s’avère que les SLMs s’attendent à avoir Python en mode interactif. Autrement dit, ils ont tendance à l’utiliser en indiquant une variable seule sur la dernière ligne et n’utilisent pas print, c.-à-d. utilisent x au lieu de print(x). J’ai bien essayé de contrer cela dans le prompt ou la description de l’outil mais sans grand succès. Au final, j’ai donc fait mon outil python_repl qui utilise la librairie ast pour parser le code et injecter l’appel à la fonction print si besoin. Certains modèles avaient d’autres biais comme utiliser un bloc de code Markdown, ou mettre tous les calculs sur une seule ligne. Comme l’objectif est de tester la connaissance du modèle et pas la bonne utilisation des appels de fonctions, j’ai un peu adapté.
Voici la description de l’outil :
Use the python function to execute Python code for math and RF calculatio Important notes:
- Each execution is independent - no state is preserved between runs.
- In REPL mode, if the last line is an unassigned expression (e.g. 142 / 7.1 or x), it is automatically printed.
- Write clean, direct code without markdown ```py block formatting (you can separate statements with semicolons: e.g. a=10; b=20; a+b).
- All variables and imports are cleared between executio Args: code (str): The python code to execu Returns: The output of the Python code.
Taux de bonnes réponses aux questions
Roulement de tambour !
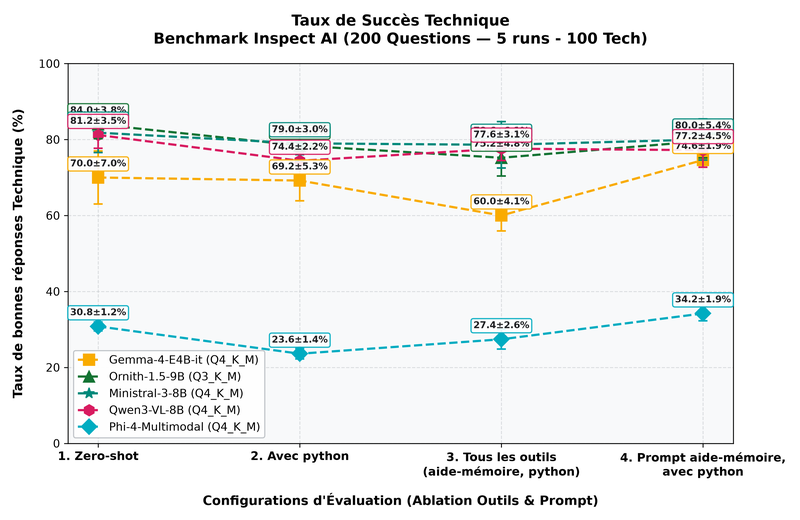
Sur un grand nombre de questions, 3 SLMs (Ornith, Qwen, Ministral) savent répondre correctement à environ 80 % des questions techniques même sans aide. C’est déjà sacrément impressionnant pour quelque chose qui tourne sur une petite carte GPU. N’oubliez pas non plus qu’il y a des images à interpréter qui ne sont pas toujours triviales.
On voit aussi que les autres configurations n’apportent rien en termes de taux de réponses correctes à une question. C’est surprenant, car nous avions introduit celles-ci pour les aider justement. Mais nous y reviendrons plus tard.
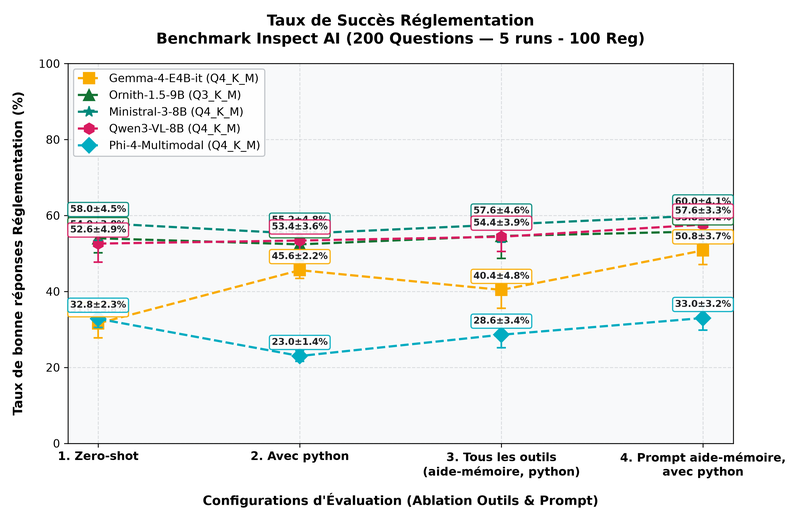
En réglementation, on retrouve le même ordre mais le taux de bonnes réponses est beaucoup plus bas, aux alentours de 50 %. La configuration 4 profite beaucoup à Gemma 4 E4B, qui revient dans le peloton de tête. C’est moins impressionnant que les questions techniques mais cela reste honorable.
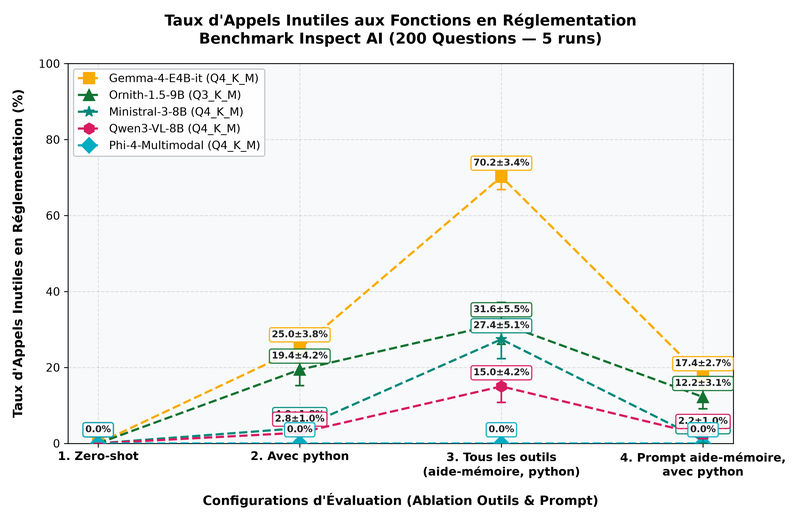
Un autre indicateur technique important est le nombre d’appels de fonctions inutiles. En effet, ce n’est pas parce qu’un des outils (lookup_bandplan, get_essential_formulas, et python) est disponible qu’il est nécessaire pour répondre à la question. Pour les questions réglementaires, il est peu probable que python serve à quelque chose. C’est ce que représente le graphe précédent. Gemma 4 ne s’en sort vraiment pas bien de ce point de vue-là. Il est très sensible à l’écriture du prompt et se fait facilement distraire par les outils. Ornith n’a pas non plus un très bon taux mais cela reste raisonnable.
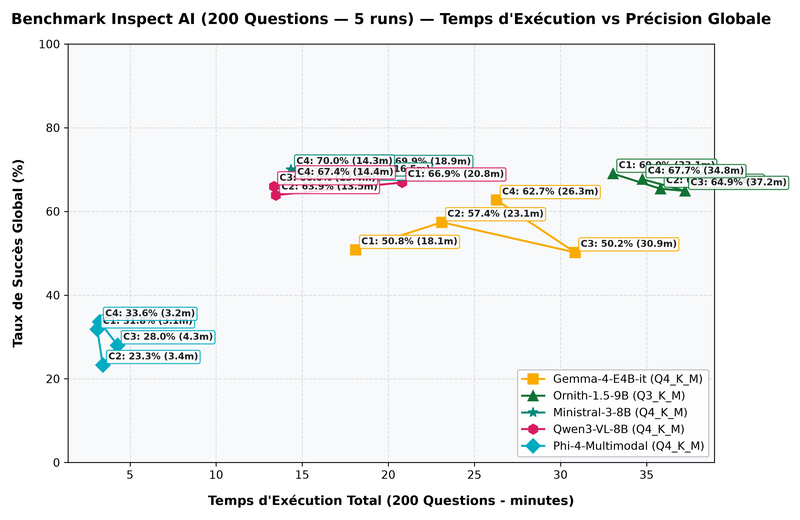
Enfin reste la question du temps d’exécution du benchmark de 200 questions eu égard aux taux de bonnes réponses (techniques et réglementaires mélangées). La frontière de Pareto montre que Qwen3-VL-8B (Q4_K_M) et Ministral-3-8B (Q4_K_M) s’en sortent particulièrement bien. Ils répondent à 200 questions en environ 15 min. C’est 20 min de moins que pour Ornith-1.5-9B (Q3_K_M).
Petite note au passage sur Phi-4-multimodal qui a dû mal à suivre les consignes et cumule les problèmes de formattage JSON pour l’appel des outils. Il mériterait sûrement un approfondissement sur la cause profonde de cela.
Taux de réussite à l’examen
Mais revenons-en à la question initiale : un SLM peut-il devenir radioamateur ?
Rappelons qu’une épreuve, c’est 2 séries de 20 questions. Pour réussir, il faut avoir ≥10/20 en technique ET en réglementation. Et c’est là que l’on retrouve l’importance des différentes configurations testées. Gagner quelques points de précision sur le taux de bonnes réponses change dramatiquement le résultat à l’examen. Les tableaux suivants équivalent à 25 sessions de 20 questions par catégorie distribués sur 5 seeds différentes pour avoir une méthode confiance statistique. Voici les taux de réussite à l’épreuve technique :
| Modèle | Config 1 (Zero-Shot) |
Config 2 (Python seul) |
Config 3 (Outils complets) |
Config 4 (Prompt + Py) |
|---|---|---|---|---|
| Gemma-4-E4B-it ✅ | 92.0% ±10.6% | 100.0% ±0.0% ✅ | 80.0% ±15.7% | 100.0% ±0.0% |
| Ornith-1.5-9B-Q3 ✅ | 100.0% ±0.0% ✅ | 100.0% ±0.0% | 100.0% ±0.0% | 100.0% ±0.0% |
| Ministral-3-8B ✅ | 100.0% ±0.0% ✅ | 100.0% ±0.0% | 100.0% ±0.0% | 100.0% ±0.0% |
| Qwen3-VL-8B ✅ | 100.0% ±0.0% ✅ | 100.0% ±0.0% | 100.0% ±0.0% | 100.0% ±0.0% |
| Phi-4-Multimodal | 8.0% ±10.6% | 0.0% ±0.0% | 4.0% ±7.7% | 4.0% ±7.7% |
Sur l’épreuve technique, Ornith, Qwen et Ministral la passent haut la main nativement (zero-shot) ! Si on rajoute Python, alors Gemma 4 aussi la réussit à chaque fois.
Voici les taux de réussite à l’épreuve réglementaire :
| Modèle | Config 1 (Zero-Shot) |
Config 2 (Python seul) |
Config 3 (Outils complets) |
Config 4 (Prompt + Py) |
|---|---|---|---|---|
| Gemma-4-E4B-it | 4.0% ±7.7% | 36.0% ±18.8% | 24.0% ±16.7% | 64.0% ±18.8% ⬆️ |
| Ornith-1.5-9B-Q3 | 76.0% ±16.7% ⬆️ | 68.0% ±18.3% | 68.0% ±18.3% | 72.0% ±17.6% |
| Ministral-3-8B ⬆️ | 88.0% ±12.7% ⬆️ | 72.0% ±17.6% | 72.0% ±17.6% | 72.0% ±17.6% |
| Qwen3-VL-8B | 56.0% ±19.5% | 72.0% ±17.6% | 76.0% ±16.7% ⬆️ | 76.0% ±16.7% |
| Phi-4-Multimodal | 0.0% ±0.0% | 0.0% ±0.0% | 0.0% ±0.0% | 12.0% ±12.7% |
Sur l’épreuve de réglementation, c’est moins net mais Ministral et Ornith s’en sortent plutôt bien en zero-shot en l’ayant 86 % du temps. Pour Qwen, c’est amusant car lui ajouter Python – qui pourtant ne sert à rien dans ce cas – lui fait réussir aussi à 86 % du temps alors qu’il est à 53 % du temps en zero-shot. Probablement que cela doit activer son chain-of-thought en interne. Peut-être qu’un prompt “Pense pas à pas” aurait eu le même effet mais avec le risque de remplir le buffer de sortie avant qu’il ne puisse donner sa réponse.
Voici les taux de réussite à l’examen :
| Modèle | Config 1 (Zero-Shot) |
Config 2 (Python seul) |
Config 3 (Outils complets) |
Config 4 (Prompt + Py) |
|---|---|---|---|---|
| Gemma-4-E4B-it | 4.0% ±7.7% | 36.0% ±18.8% | 16.0% ±14.4% | 64.0% ±18.8% ⬆️ |
| Ornith-1.5-9B-Q3 | 76.0% ±16.7% ⬆️ | 68.0% ±18.3% | 68.0% ±18.3% | 72.0% ±17.6% |
| Ministral-3-8B ⬆️ | 88.0% ±12.7% ⬆️ | 72.0% ±17.6% | 72.0% ±17.6% | 72.0% ±17.6% |
| Qwen3-VL-8B | 56.0% ±19.5% | 72.0% ±17.6% | 76.0% ±16.7% ⬆️ | 76.0% ±16.7% |
| Phi-4-Multimodal | 0.0% ±0.0% | 0.0% ±0.0% | 0.0% ±0.0% | 0.0% ±0.0% |
Ministral-3-8B est impressionnant en Zero-shot. Non seulement il fait partie des modèles les plus rapides à executer mais en plus il n’a pas besoin d’être outillé pour réussir l’examen. Ornith-1.5-9B-Q3 le talonne mais est beaucoup plus lent (sur ma machine). Gemma 4 a lui aussi ses chances de devenir radio-amateur dans la configuration 4. On voit là l’intérêt de diminuer la complexité du contexte en limitant le nombre d’outils. Au final, il est très probable qu’un SLM local devienne radioamateur. C’est d’autant plus amusant de lire ces taux de réussite vis-à-vis des chiffres de l’observatoire des radioamateurs. Ainsi, en 2025, 548 personnes ont obtenu l’examen contre 142 qui ont échoué… soit un taux de ~79 % ! Autrement dit, les meilleurs SLMs ont autant de chances de devenir radioamateur qu’un humain (mais sans stress).
Les questions bloquantes
Une dernière analyse intéressante est l’analyse des questions d’échec systématique. C’est-à-dire celles qui font systématiquement échouer les modèles (100 % d’erreur). Probablement que chacune d’entre elles pourrait être suppléée par un outil spécifique (RAG, outils des préfixes, etc.).
On peut les classifier en 6 catégories de pièges & biais cognitifs :
- Biais Mathématique vs Physique (DC/AC) : Le piège de la pile 100 V sur le transformateur (ID 21436). Un transformateur ne fonctionne qu’avec du courant alternatif !
- Confusion TOS vs Réflexion : L’optimisation vers le TOS idéal de 1 vs Γ = 0 (ID 34789).
- Tableaux CEPT/UIT des préfixes : Confusions d’inversion de préfixes (LY Lituanie, LA Norvège, MM Écosse). Un LLM différencie difficilement LY (Lituanie) et YL (Lettonie), ou encore le suffixe MM (mobile maritime) du préfixe MM (Écosse).
- Norme ITU SM.1138 & Codification : Encodage de largeur de bande (3M50 pour 3,5 MHz) et 1er caractère de classe.
- Physique des Antennes Yagi : La chute d’impédance au point d’alimentation lors de l’ajout d’éléments.
- Propagation Ionosphérique Jour/Nuit : L’obligation d’augmenter la fréquence de jour pour traverser la couche D et se réfléchir sur la couche F.
Conclusion
L’exercice fut fort intéressant et plein de rebondissements. On se rend vraiment compte de ce que signifie créer un benchmark. Cela m’a permis aussi de pousser mon matériel à fond et de voir l’état actuel des SLMs. Les progrès sont indéniables, en particulier en technique. Mais on voit aussi les failles restantes. Quant à la question de fond, oui, un SLM avec uniquement une calculatrice peut devenir radioamateur, autant qu’un humain pourrait le devenir !
N’allez pas conclure pour autant qu’un SLM n’est pas fiable pour ce genre de questions. En effet, j’ai gardé un prompt neutre qui fonctionne moyennement sur tous les modèles. Je suis persuadé que l’on peut trouver un prompt et des outils qui permettent à un modèle d’atteindre quasiment les 100% et qui pourraient être utiles au quotidien. Et quand je dis au quotidien, je pense aussi en tant que tuteur utilisant la méthode socratique. Je pense que je ferai d’ailleurs une recherche sur Ministral afin d’obtenir un 100% tout le temps. Ce sera probablement l’objet d’un prochain article.
NB : Je vais voir qu’elle est la licence des questions afin de publier l’ensemble du code et du dataset modifié.